Data Governance in der Praxis: Wie ENERCON Stammdatenmanagement unternehmensweit verankert
Christian Friedrich, Head of Material Master Data bei ENERCON Global GmbH, über Datenverantwortung, Datenkultur, messbare Datenqualität und die Voraussetzungen für den erfolgreichen Einsatz von KI.
Warum treten Datenprobleme immer wieder auf, obwohl Regeln und Zuständigkeiten eigentlich festgelegt sind? Und wie gelingt es, Data Governance so im Unternehmen zu verankern, dass Datenverantwortung im Arbeitsalltag tatsächlich gelebt wird?
Im Interview berichtet Christian Friedrich von seinen Erfahrungen bei ENERCON. Er erklärt, warum Data Governance mehr als Richtlinien und Gremien braucht, wie ein Bottom-up-Ansatz Veränderungen anstoßen kann und weshalb eine verlässliche Datengrundlage auch für den Einsatz künstlicher Intelligenz entscheidend ist.
Über ENERCON und Christian Friedrich
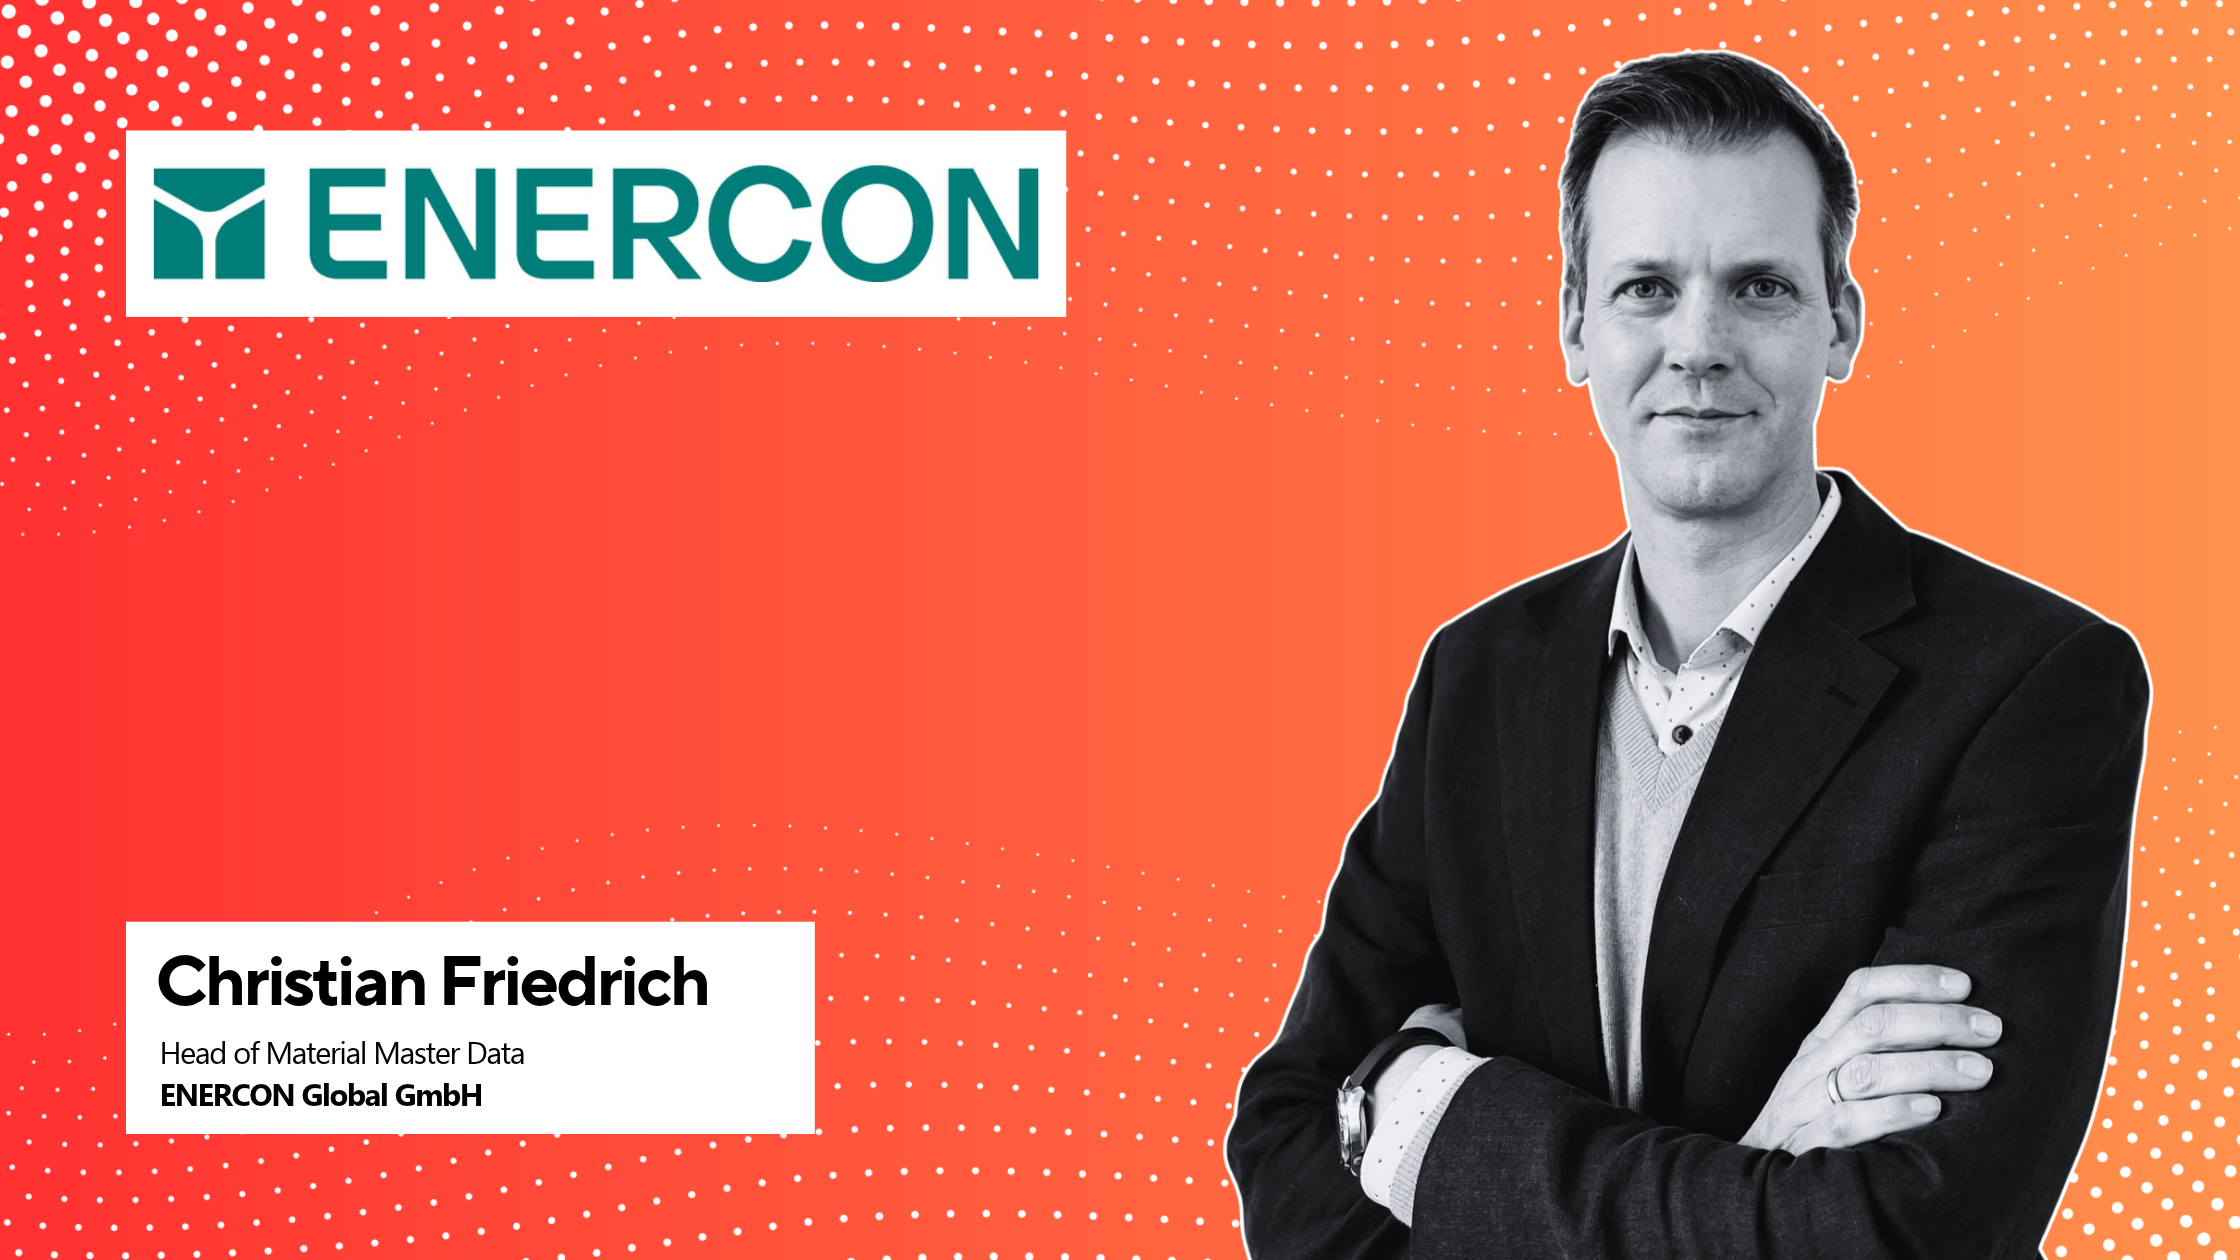
Christian Friedrich ist Head of Material Master Data bei der ENERCON Global GmbH. Als Hersteller von Windenergieanlagen beschäftigt sich ENERCON mit komplexen Datenstrukturen und den Anforderungen an ein wirksames Stammdatenmanagement.
Christian Friedrich bringt Erfahrungen aus den Bereichen Wirtschaftsinformatik, PLM, Prozessmanagement und Datenmanagement mit. Bei ENERCON beschäftigte er sich unter anderem mit Prozessmanagement und der Einführung eines neuen PLM-Systems. 2024 erhielt er den Auftrag, eine unternehmensweite Data Governance zu planen und umzusetzen.
Das Interview
Stammdatenmanagement und Data Governance werden häufig gemeinsam genannt. Wie hängen die beiden Themen aus Ihrer Sicht zusammen, und warum ist Data Governance für ein erfolgreiches Stammdatenmanagement so wichtig?
Für mich ist Data Governance das Fundament eines nachhaltigen Stammdatenmanagements. Ohne klare Verantwortlichkeiten und Regeln wird aus Stammdatenmanagement schnell Data Cleansing in Dauerschleife: Man behebt immer wieder dieselben Datenprobleme, statt ihre Ursachen zu beseitigen. Oder anders gesagt: Man jätet ständig Unkraut, aber niemand kümmert sich darum, warum es immer wieder nachwächst.
Data Governance ist in vielen Unternehmen ein wichtiges Thema, gleichzeitig fällt die praktische Umsetzung oft schwer. Woran liegt das Ihrer Erfahrung nach?
„Daten sind das neue Öl“ – so wird es beschrieben, allerdings wird das so auch in den Unternehmen gelebt? Solange Datenverantwortung nebenbei wahrgenommen wird, Ressourcen fehlen oder Datenqualität erst Aufmerksamkeit bekommt, wenn Probleme entstehen, bleibt Data Governance eine gute Idee statt gelebter Praxis.
Aus meiner Sicht ist erfolgreiche Data Governance deshalb vor allem ein Kulturthema. Erst wenn Daten tatsächlich wie ein Unternehmenswert behandelt werden, ändern sich die Prioritäten.
Zudem gibt es verschiedene Herangehensweisen und unternehmerische Umweltfaktoren zur Umsetzung. Entweder ordert das Top-Management eine Data Governance an (top-down), oder es keimt aus einzelnen Fachbereichen hervor (bottom up) – beides schwierig für eine unternehmensweite Umsetzung. Ideal ist ein Mix daraus.
Die erfolgreiche Umsetzung einer Data Governance und die Transformation in eine data-driven Organisation hängen aber von weiteren Faktoren ab. Diese Fragen stellen sich somit:
-
Geht die technische Reife (Datenkatalog, Knowledge Graph, Datensilos aufbrechen etc.) mit der organisatorischen Datenkultur einher und wird dies auch durch das mittlere Management vorgelebt und als Mehrwert (#data-to-value) gesehen?
-
Kann anhand der Datenvision die spezifischen Strategien für die jeweiligen Fachbereiche abgeleitet werden, bei denen #Data-Driven die Grundlage ist?
-
Sind Prozesse, Daten, Technik und Organisation verbunden und wird das gelebt? Thema: „…alle wollen AI, aber die Datengrundlage und das Knowledge fehlt.“
-
Gibt es klare und transparente Verantwortung zu den Datenobjekten und wie spielen diese im Daten-Lebenszyklus zusammen?
In vielen Unternehmen wird Data Governance als lästige Dokumentation gesehen. Aber, anstatt eine 1000 Seiten starke Governance-Bibel zu schreiben und nach einem Jahr dem C-Level zu präsentieren, sollte man mit Pilotprojekten starten.
Mein Ansatz hier: #fail-fast! Ohne schnelle und agile Ansätze verbaut man sich den unternehmensweiten Rollout. Wenn Erfolge erzielt werden und Datenwerte beschaffen werden, müssen diese gefeiert werden – zur Stärkung der Datenkultur.
Unklare Verantwortlichkeiten, unterschiedliche Datenstandards und historisch gewachsene Strukturen können das Stammdatenmanagement erschweren. Wo sehen Sie in der Praxis die größten Herausforderungen?
Eine der größten Herausforderungen ist, dass Datenobjekte während ihres Lebenszyklus durch viele Hände gehen. Dadurch entstehen Übergänge, an denen Verantwortung verschwimmt. Wenn nicht klar geregelt ist, wer wann welche Verantwortung übernimmt, wird aus einem Datenproblem schnell ein Organisationsproblem.
Bei Enercon verfolgen wir einen föderalistischen Ansatz zur Data Governance. Die zentrale Ebene definiert den gemeinsamen Rahmen, während die Fachbereiche innerhalb dieses Rahmens ihre Daten eigenverantwortlich steuern.
Historisch gewachsene Strukturen müssen hinterfragt werden. Eine Lücke in der Daten-Verantwortung wird meist mit Muskelkraft aus anderen Bereichen gestemmt (#ask Tom). Hier ist der zentrale Ansatz mit den jeweiligen Data Governance Gremien wichtig, um hier eine Balance zu schaffen und vermeintliche Verantwortungslücken zu schließen.
Am Ende ist gutes Stammdatenmanagement keine technische Disziplin, sondern eine Veränderungsdisziplin. Die Datenbank lässt sich in wenigen Wochen anpassen. Gewohnheiten zu verändern dauert oft Jahre.
Sie haben bei ENERCON einen Bottom-up-Ansatz für die Einführung von Data Governance verfolgt. Was macht diesen Ansatz besonders interessant, und warum kann es sinnvoll sein, Veränderungen aus der operativen Praxis heraus anzustoßen?
Wir haben mit einem Bottom-up-Ansatz begonnen, weil wir uns auf ein klar abgegrenztes Datenumfeld konzentrieren wollten, statt von Beginn an die gesamte Organisation verändern zu müssen.
Das hat uns ermöglicht, schnelle Erfolge zu erzielen, notwendige Anpassungen in PLM- und ERP-Systemen umzusetzen und neue Rollen in einem überschaubaren Umfeld zu etablieren. Gleichzeitig konnten wir Erfahrungen sammeln, Fehler machen und daraus lernen.
Aus diesen Erfahrungen entstand eine Blaupause für die weitere Einführung von Data Governance im Unternehmen. Die sichtbaren Erfolge haben Aufmerksamkeit geschaffen und den Weg für einen unternehmensweiten Rollout geebnet.
Oft wird versucht, Data Governance direkt als unternehmensweites Programm einzuführen. Wir sind den umgekehrten Weg gegangen: erst Mehrwert schaffen, dann skalieren.
Wie gelingt es, Mitarbeitende und Fachbereiche für Data Governance zu gewinnen und das Thema dauerhaft in einer Organisation zu verankert?
Menschen interessieren sich nicht für Data Governance. Sie interessieren sich für ihre täglichen Herausforderungen.
Niemand steht morgens auf und denkt: „Heute möchte ich Datenverantwortung übernehmen.“
Sie möchten Antworten finden, statt Ansprechpartner zu suchen. Entscheidungen treffen, statt Zuständigkeiten zu diskutieren. Probleme lösen, statt sie von Meeting zu Meeting zu tragen.
Deshalb kann man eine Datenkultur nicht verordnen. Wer es versucht, bekommt Compliance. Wer Menschen mitnimmt, bekommt Veränderung.
Der Schlüssel liegt darin, die Fachbereiche dort abzuholen, wo sie stehen: Ihre Herausforderungen zu verstehen, Hindernisse aus dem Weg zu räumen und gemeinsam Lösungen zu entwickeln. Erst wenn Data Governance einen spürbaren Nutzen im Alltag schafft, wird sie akzeptiert.
Am Ende kann man eine Datenkultur nicht erzwingen. Man kann nur die richtigen Bedingungen schaffen: Orientierung geben, unterstützen, Hindernisse beseitigen und Geduld haben.
So entsteht Verankerung. Nicht durch Druck, sondern durch kontinuierliche Begleitung und sichtbare Erfolge.
Als Head of Material Master Data bei ENERCON beschäftigen Sie sich mit den Herausforderungen des Materialstammdatenmanagements. Welche Erfahrungen aus diesem Umfeld lassen sich auch auf andere Unternehmen und Branchen übertragen?
Die wichtigste Erfahrung aus dem Materialstammdatenmanagement ist für mich, dass Datenprobleme selten reine Datenprobleme sind.
In der Praxis sind sie meist das Ergebnis eines Ungleichgewichts zwischen Daten, Prozessen, Technik und Organisation. Genau dieses Zusammenspiel muss betrachtet werden, unabhängig davon, ob wir über Materialstammdaten, Finanzdaten oder andere Datendomänen sprechen.
Wir kommen aus einer Organisation, die in der Vergangenheit sehr stark auf Prozesse ausgerichtet war. Das hat uns gezeigt, dass Prozessoptimierung allein nicht ausreicht. Prozesse müssen immer gemeinsam mit den zugrunde liegenden Daten, den technischen Rahmenbedingungen und den Verantwortlichkeiten in der Organisation betrachtet werden.
Das Modell dieser vier Faktoren ist nicht neu. Die konsequente Anwendung ist jedoch komplex und zeitintensiv. Aus unserer Erfahrung lohnt sich diese Investition, denn wer nicht investiert, wird nicht future-ready und verliert langfristig an Wettbewerbsfähigkeit.
Wie können Unternehmen erkennen, ob ihre Data Governance tatsächlich Wirkung zeigt? Welche Bedeutung hat es, Fortschritte und Datenqualität messbar zu machen?
Für mich zeigt sich der Erfolg von Data Governance nicht daran, dass es mehr Rollen, Richtlinien oder Gremien gibt. Er zeigt sich daran, dass das Geschäft besser funktioniert.
Es ist relativ einfach, einen Data Owner zu benennen oder ein Governance Board zu etablieren. Die schwierigere Frage lautet: Hat sich dadurch tatsächlich etwas verbessert?
Wenn bessere Stammdaten weniger Bestellfehler verursachen, Produktionsunterbrechungen vermeiden, die Automatisierungsquote erhöhen oder verlässlichere Reports und KI-Anwendungen ermöglichen, wird der Wert von Data Governance für das Unternehmen sichtbar.
Genau deshalb ist Messbarkeit so wichtig. Denn ohne Messbarkeit bleibt Erfolg eine Wahrnehmung. Mit Messbarkeit wird Wirkung sichtbar.
Dabei sollte man aus meiner Sicht auf drei Ebenen messen:
-
Governance messen: Sind Verantwortlichkeiten definiert und transparent dargestellt? Sind Business Data Stewards befähigt und spielen diese in einem Team mit dem Data Owner? Werden kritische Datenobjekte und Qualitätsregeln gepflegt? Sind Prozesse mit Daten verbunden?
-
Daten messen: Werden die Daten tatsächlich besser? Steigt beispielsweise die Vollständigkeit und Korrektheit von Stammdaten von 85 % auf 97 %?
-
Business-Impact messen: Verbessern sich dadurch Durchlaufzeiten, Prozesse, Kosten, Automatisierung und Entscheidungen?
Wichtig sind dabei nicht einzelne Kennzahlen, sondern die Entwicklung über Wochen und Monate. Wie hat sich die Datenqualität verändert? Welche Maßnahmen haben zu Verbesserungen geführt? Und welchen Beitrag leisten diese Verbesserungen zu Automatisierung, besseren Entscheidungen, Szenariosimulationen oder einer höheren First-Time-Right-Quote?
Man bekommt das, was man misst. Wenn wir nur zählen, wie viele Rollen besetzt und Richtlinien verabschiedet wurden, werden wir mehr Rollen und Richtlinien bekommen. Wenn wir Wirkung messen, werden wir mehr Wirkung bekommen.
Aus diesem Grund haben wir ein eigenes Reifegradmodell entwickelt, mit dem wir den Fortschritt der Data Governance auf Datenfeldebene transparent messen können.
Welche Rolle wird künstliche Intelligenz künftig im Stammdatenmanagement spielen und was sollten Unternehmen bereits heute dafür vorbereiten?
KI wird in jedem Bereich strategische Bedeutung bekommen. Gerade im Stammdatenmanagement eröffnet sie enorme Potenziale, weil viele Aufgaben heute noch von Fachwissen, manuellen Prüfungen und Abstimmungsschleifen geprägt sind. Künftig können solche Tätigkeiten durch KI unterstützt oder teilweise automatisiert werden.
Gleichzeitig wird KI die Bedeutung guter Stammdaten weiter erhöhen. Denn KI kann schlechte Stammdaten nicht heilen, sondern macht deren Auswirkungen oft nur schneller und sichtbarer.
Deshalb sollten Unternehmen nicht nur über KI-Anwendungen nachdenken, sondern bereits heute die Voraussetzungen dafür schaffen. Neben der technischen Infrastruktur braucht es eine klare Strategie, qualifizierte Mitarbeitende, angepasste Prozesse und vor allem eine verlässliche Datengrundlage.
Wer KI erfolgreich einsetzen möchte, muss zuerst #data-ready werden. Data Governance und Datenmanagement sind deshalb keine Konkurrenz zu KI, sondern ihre Voraussetzung.
Oder anders gesagt: Viele Unternehmen fragen sich aktuell, wie sie KI einführen können. Die entscheidendere Frage lautet oft: Sind ihre Daten überhaupt bereit dafür?
Zum Abschluss
„Gutes Stammdatenmanagement (oder Data Governance) ist für mich …“
…ein wirkungsvolles und smartes Zusammenspiel von 4 Ebenen: Menschen, Daten, Prozessen und neuester Technologie.
Data Governance und Stammdatenmanagement: Austausch beim Stammdaten Forum 2026
Wie können Unternehmen ihre Stammdatenqualität verbessern, klare Datenverantwortlichkeiten schaffen und Data Governance wirksam in der Organisation verankern sowie die Grundlage für Automatisierung und KI schaffen? Die Erfahrungen von Christian Friedrich zeigen, dass es dafür nicht nur Regeln und technische Lösungen braucht, sondern auch die aktive Einbindung der Fachbereiche und ein abgestimmtes Zusammenspiel von Menschen, Daten, Technik und Prozessen.
Beim Stammdaten Forum am 25. und 26. November 2026 in Düsseldorf stehen diese und weitere Fragen rund um Stammdatenmanagement, Data Governance, Datenqualität und digitale Transformation im Mittelpunkt. Fach- und Führungskräfte, Entscheider und Praktiker erhalten die Gelegenheit, Erfahrungen auszutauschen, konkrete Herausforderungen zu diskutieren und Impulse für die eigene Praxis mitzunehmen.
Aus der Praxis – für die Praxis: Nutzen Sie den Austausch mit der Stammdaten-Community im DACH-Raum und entwickeln Sie neue Ansätze für Ihr Stammdatenmanagement.
Termin: 25.–26. November 2026
Ort: Düsseldorf
Weitere Informationen zum Programm und zur Anmeldung finden Sie hier: https://www.deutsche-kongress.de/veranstaltung/stammdaten-forum/